V dnešním světě nepřetržitého provozu systémů vedou technické incidenty k vážným následkům.
Každá hodina výpadku systému stojí společnosti v průměru 300 150 USD ve ztrátě příjmů, ztrátě produktivity zaměstnanců a nákladech na údržbu. V případě rozsáhlých poruch mohou náklady raketově vzrůst (viz Delta Airlines, která kvůli výpadku IT v roce 2017 ztratila asi XNUMX milionů dolarů). Zákazníci, kteří nemohou platit účty, pořádat důležitou videokonferenci nebo si koupit letenku, se rychle obracejí ke konkurenci.
V sázce je hodně. Proto je pro týmy zásadní sledovat klíčové ukazatele výkonu správy incidentů a používat výsledky k identifikaci, diagnostice, nápravě a nakonec k prevenci incidentů.
Nejlepší je, že při řešení webových a softwarových incidentů (na rozdíl od mechanických poruch a vypínání systému) mají týmy k dispozici mnohem více dat. Mohou tak efektivněji porozumět situaci a provést zlepšení.
Ale jsou tu i nevýhody. Někdy je obtížnější porozumět problému, když existuje velké množství dat.
Hodnota klíčových ukazatelů výkonu, metrik a analytiky při správě incidentů
Klíčové ukazatele výkonnosti (KPI) pomáhají společnostem určit, zda dosahují konkrétních cílů. V kontextu správy incidentů by těmito metrikami mohl být počet incidentů, průměrná doba do vyřešení nebo průměrná doba mezi incidenty.
Sledováním klíčových ukazatelů výkonu správy incidentů můžete identifikovat a diagnostikovat problémy s procesy a systémy, nastavit měřítka a realistické cíle pro výkon týmu a poskytnout výchozí bod pro řešení problémů velkého rozsahu.
Řekněme, že se společnost snaží vyřešit všechny incidenty do 30 minut, ale váš tým to zvládne v průměru za 45 minut. Bez konkrétních ukazatelů je obtížné pochopit, v čem je problém. Je váš poplašný systém příliš pomalý? Něco v procesu nefunguje? Potřebujete pokročilejší diagnostické nástroje? Týká se tento problém týmu nebo vybavení?
Nyní přidejte metriky. Pokud přesně víte, jak dlouho trvá, než se poplašný systém spustí, můžete zjistit, zda je příčinou problému. Pokud diagnostika zabere více než polovinu času, můžete se zaměřit na jejich odstraňování. Pokud je tým B o 25 % pomalejší než týmy A, C a D, můžete se pokusit pochopit, proč se to děje.
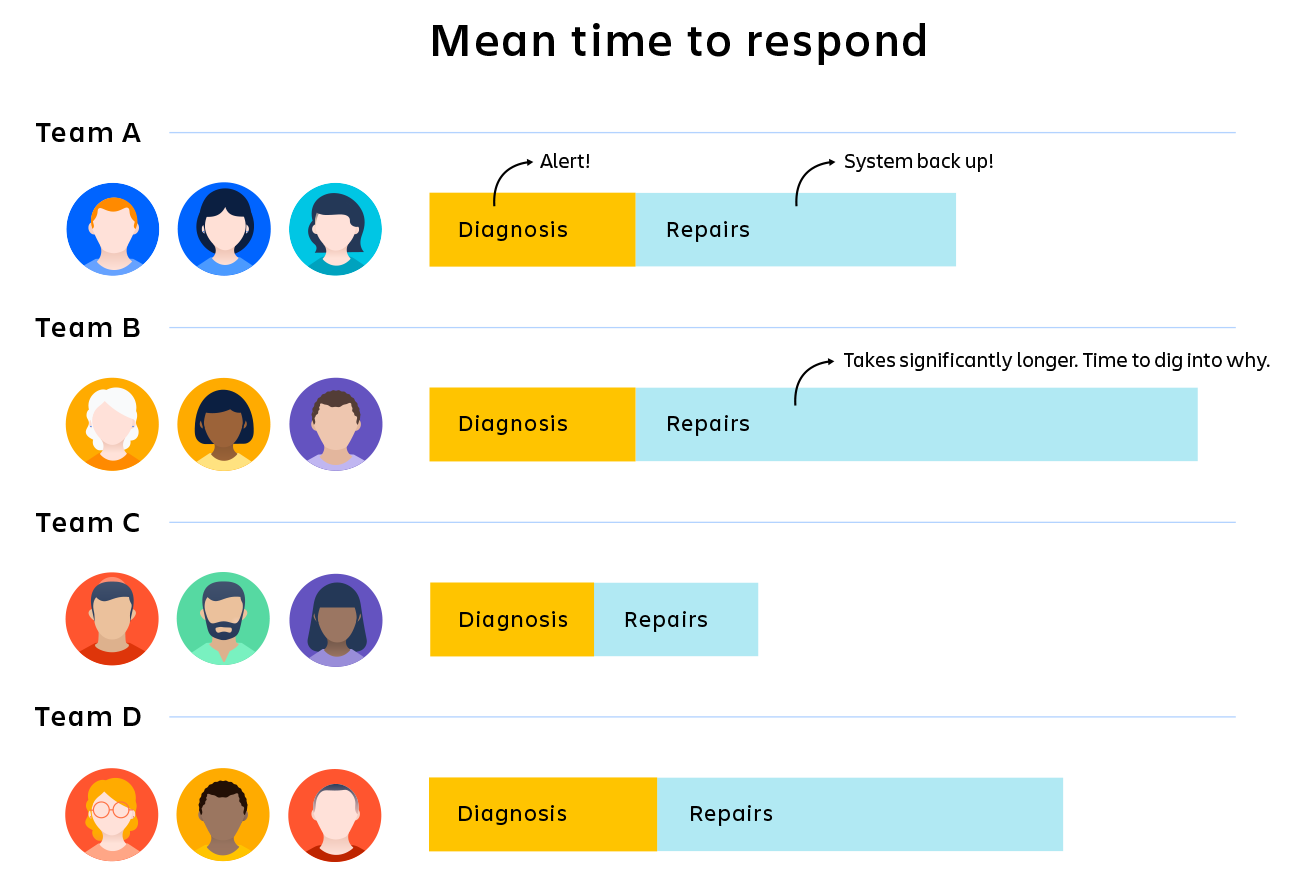
KPI automaticky nevyřeší vaše problémy, ale mohou vám pomoci pochopit, co je špatně, a ukázat vám, kam zaměřit svou pozornost a úsilí.
Oblíbené KPI a metriky pro správu incidentů
Počet vytvořených upozornění
Pokud používáte výstražný nástroj, je užitečné vědět kolik upozornění je vygenerováno za určité časové období. Pomocí správy služeb Jira můžete odesílat upozornění a vytvářet sestavy a řídicí panely pro jejich sledování.
Hledejte období výrazného nebo neobvyklého růstu nebo poklesu, stejně jako pozitivní trendy. Když takové změny zjistíte, analyzujte důvody a to, jak na ně vaše týmy reagují.
Počet incidentů za určité časové období
Sledování počtu incidentů za určité časové období zahrnuje výpočet průměrného počtu incidentů za dané období. Toto období může být týden, měsíc, čtvrtletí, rok nebo dokonce den.
Dochází k incidentům v průběhu času častěji nebo méně často? Je počet incidentů přijatelný, nebo jej lze snížit? Jakmile pochopíte, v čem je problém s počtem incidentů, můžete hádat, proč tento počet stoupá nebo zůstává vysoký a co může tým udělat, aby problém vyřešil.
MTBF
MTBF (střední doba mezi poruchami) je průměrná doba provozu technického výrobku mezi opravitelnými poruchami. Tato metrika vám pomáhá sledovat dostupnost a spolehlivost všech produktů.
Stejně jako ostatní indikátory vede k rozsáhlejším otázkám. Pokud MTBF není dostatečně vysoká, stojí za to zvážit, proč systémy tak často selhávají a jak můžete budoucím poruchám snížit nebo jim předejít.
MTTA
MTTA (Mean Time to Acknowledge) je průměrná doba, která uplyne mezi obdržením výstrahy a dobou, kdy člen týmu incident potvrdí a začne pracovat na jeho vyřešení.. Tato metrika je důležitá, protože vám může pomoci pochopit, jak rychle váš tým reaguje na incidenty.
Pokud se ukáže, že míra odpovědí není dostatečně vysoká, můžete klást nové otázky. Proč je hodnota MTTA tak vysoká? Jsou týmy přemožené, rozptýlené nebo zmatené z toho, pro koho je výstraha určena? MTTA vám může pomoci identifikovat problém a kladení otázek, jako je tato, vám může pomoci dostat se ke kořenu problému.
MTTD
MTTD (Mean Time to Detect) je průměrná doba, kterou váš tým potřebuje k odhalení problému. Tento termín je v odvětví kybernetické bezpečnosti často používán týmy, které se zaměřují na odhalování útoků a neoprávněného přístupu.
Pokud se hodnota tohoto ukazatele prudce změní nebo zůstane nedostatečně vysoká, stojí za to zjistit důvod.
MTTR
MTTR může znamenat čas na opravu, vyřešení, reakci nebo obnovení. Snad největším přínosem je průměrná doba řešení. Tento indikátor umožňuje zaznamenat nejen čas strávený diagnostikou a řešením okamžitého problému, ale také čas strávený předcházením opakování takového problému v budoucnu. Obnova je hlavní metrikou DevOps; to je to, o čem se program DevOps Research and Assessment (DORA) domnívá, že lze použít k posouzení stability týmu DevOps.
Hodnota tohoto ukazatele se nejlépe prokáže při diagnostice. Jsou incidenty vyřešeny tak rychle a efektivně, jak jste očekávali? Pokud ne, musíte zjistit, proč doba rozlišení nesplňuje cílovou hodnotu.
Obnova je hlavní metrikou DevOps; to je to, o čem se program DevOps Research and Assessment (DORA) domnívá, že lze použít k posouzení stability týmu DevOps. To je celkový čas, který zabere odhalení problému, zmírnění jeho dopadů a jeho úplné odstranění.
Pracovní doba
Pokud máte tým rotujících služeb, doporučujeme to sledovat, kolik času zaměstnanci a dodavatelé tráví hovory.Pomocí této metriky můžete zajistit, že žádný jednotlivec ani tým nebude přepracován.
S Jira Service Management můžete vytvářet komplexní sestavy, abyste okamžitě pochopili hodnotu těchto metrik.
sla
SLA (service level agreement) je dohoda mezi dodavatelem a klientem o měřitelných metrikách, jako je doba provozuschopnosti, doba odezvy a měřítka odpovědnosti.
Tyto smlouvy o úrovni služeb dokumentují sliby společnosti (o době provozuschopnosti, střední době do obnovy atd.). Aby je týmy správy incidentů obsahovaly, musí tyto metriky sledovat. Pokud a když se změní hodnoty pro metriky, jako je průměrná doba odezvy nebo střední doba mezi poruchami, je třeba aktualizovat dohody a/nebo provést opravy (a to se musí stát rychle).
SLO
SLO (service level goal) je dohoda v rámci SLA o cílové hodnotě konkrétního ukazatele, například uptime. Stejně jako u SLA jsou SLO důležitými metrikami, které je třeba sledovat, aby bylo zajištěno, že společnost dodrží svůj konec smlouvy, pokud jde o služby zákazníkům.
Časové razítko (nebo časová osa)
Časové razítko je kódovaná informace o tom, co se stalo v určitou dobu během, před nebo po incidentu.. Tyto informace se obvykle nepovažují za indikátor, ale jsou to důležité údaje, které je třeba vzít v úvahu při posuzování stavu řízení incidentů a vytváření strategie pro zlepšení.
Pomocí časových razítek týmy určují chronologii incidentu, stejně jako předchozí události a kroky podniknuté k jeho vyřešení. Časová osa, která je jasná a přístupná všem účastníkům, je jedním z nejužitečnějších artefaktů během rozboru incidentů.
Doba provozuschopnosti
Uptime je doba (v procentech), po kterou jsou systémy dostupné a funkční.
S rozšiřováním propojení mezi online službami a rostoucí složitostí samotných systémů se ukázalo, že Nelze zaručit 100% bezporuchový provoz. V případě většiny produktů je cílem zajistit vysokou dostupnost, tedy vytvořit systém nebo produkt, který může fungovat bez přerušení po dlouhou dobu. Průmyslovým standardem je, že 99,9% dostupnost je velmi dobrá a 99,99% dostupnost je vynikající.
Sledování hodnot tohoto ukazatele je povinné pro plnění slibů daných zákazníkům. Stejně jako ostatní indikátory představuje pouze výchozí bod. Pokud není dosaženo 99,99% doby provozuschopnosti, pochopení příčiny bude vyžadovat hlubší zkoumání problému, rozhovor s týmem a přezkoumání procesu, návrhu, přístupu nebo technologie.
Na co si dát pozor při analýze incidentů
KPI mají nevýhody. Takže je to možné Je snadné stát se závislými na tenkých datech. Pokud váš tým nevyřeší incidenty dostatečně rychle, bude k vyřešení problému zapotřebí více než jen informovanost. Musíte pochopit как и proč tým řeší nebo neřeší problémy. Musíte také vědět, zda jsou problémy, které srovnáváte, srovnatelné.
KPI vám neřeknou, jak vaše týmy přistupují ke komplexním problémům, proč k incidentům dochází častěji nebo proč řešení incidentu A trvalo třikrát déle než incidentu B.
To vyžaduje analytické závěry. Data však mohou být nejen výchozím bodem na cestě k těmto závěrům, ale také bariérou. Mohou vytvářet falešný dojem o efektivním výkonu, když se výkon nezlepšuje. Ukazatele neberou v úvahu rozdíly (někdy poměrně významné) mezi incidenty nebo přístupy k jejich řešení. Co také zůstalo pozadu, jsou zkušenosti vašich týmů a základní složitost samotných incidentů.
«Tyto incidenty jsou mnohem unikátnější, než se běžně předpokládá. Dva incidenty, které lze vyřešit v jednom časovém úseku, se mohou výrazně lišit v tom, jak neočekávané a nepochopitelné pro odpovědné specialisty byly. Kromě toho mohou zmírňující nebo nápravná opatření při různých incidentech představovat zcela odlišná rizika. Incidenty nejsou díly z montážní linky, jejichž indikátorem kvality je omezená odchylka fyzických rozměrů,“
—John Allspaw, pohyb kolem mělkých dat incidentů
Neříkáme, že KPI jsou neúčinné, a nevyzýváme k jejich opuštění. Faktem je, že samotné KPI nestačí. Ty by měly být použity jako výchozí bod. Pomohou identifikovat příčinu problému a stanou se prvním krokem na obtížné cestě k efektivnímu zlepšení.
Jira Service Management nabízí možnosti vytváření sestav, takže váš tým může sledovat KPI a monitorovat a optimalizovat správu incidentů.


